Conçu pour les charges de travail qui façonnent l'IA de nouvelle génération
LLM à grande échelle
Entraînez, affinez et déployez des modèles de pointe sans que la mémoire devienne le goulot d'étranglement.
Avec de la HBM4 sur chaque GPU et une bande passante mémoire en forte hausse, HGX Rubin NVL8 accueille des modèles plus volumineux, des fenêtres de contexte plus longues et davantage d'utilisateurs simultanés par nœud. Vous servez plus de requêtes en production, avec moins de compromis.
IA multimodale
Texte, image, audio et vidéo sur une seule et même plateforme.
Les pipelines multimodaux exigent à la fois de la puissance de calcul brute et des transferts de données rapides. HGX Rubin NVL8 équilibre les deux. Vous développez et exécutez vos modèles multimodaux de nouvelle génération sans que l'un freine l'autre.
IA de raisonnement et agentique
Plus de tokens par requête, sans perte de réactivité.
Les modèles de raisonnement et les agents IA génèrent bien plus de tokens par tâche que l'inférence classique. HGX Rubin NVL8 réunit une grande capacité mémoire, une bande passante élevée et la connectivité NVLink. Il soutient ce débit en gardant une latence faible, là où les plateformes à mémoire plus limitée atteignent leurs limites.
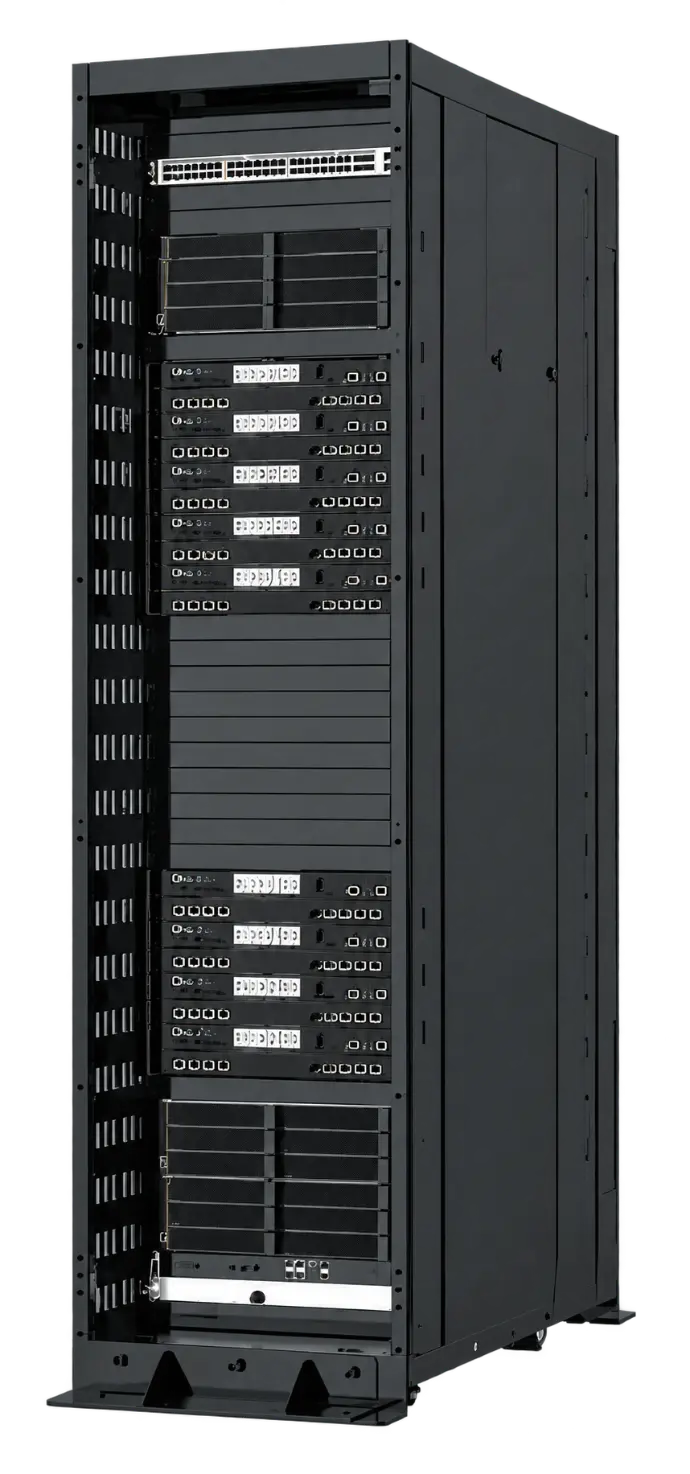
Déploiement clé en main / Certifié NVIDIA / Distribution électrique redondante / Évolutivité multi-racks
Solution rack
configurée pour l’IA à grande échelle
Déployer des AI Factories à l'échelle de l'entreprise
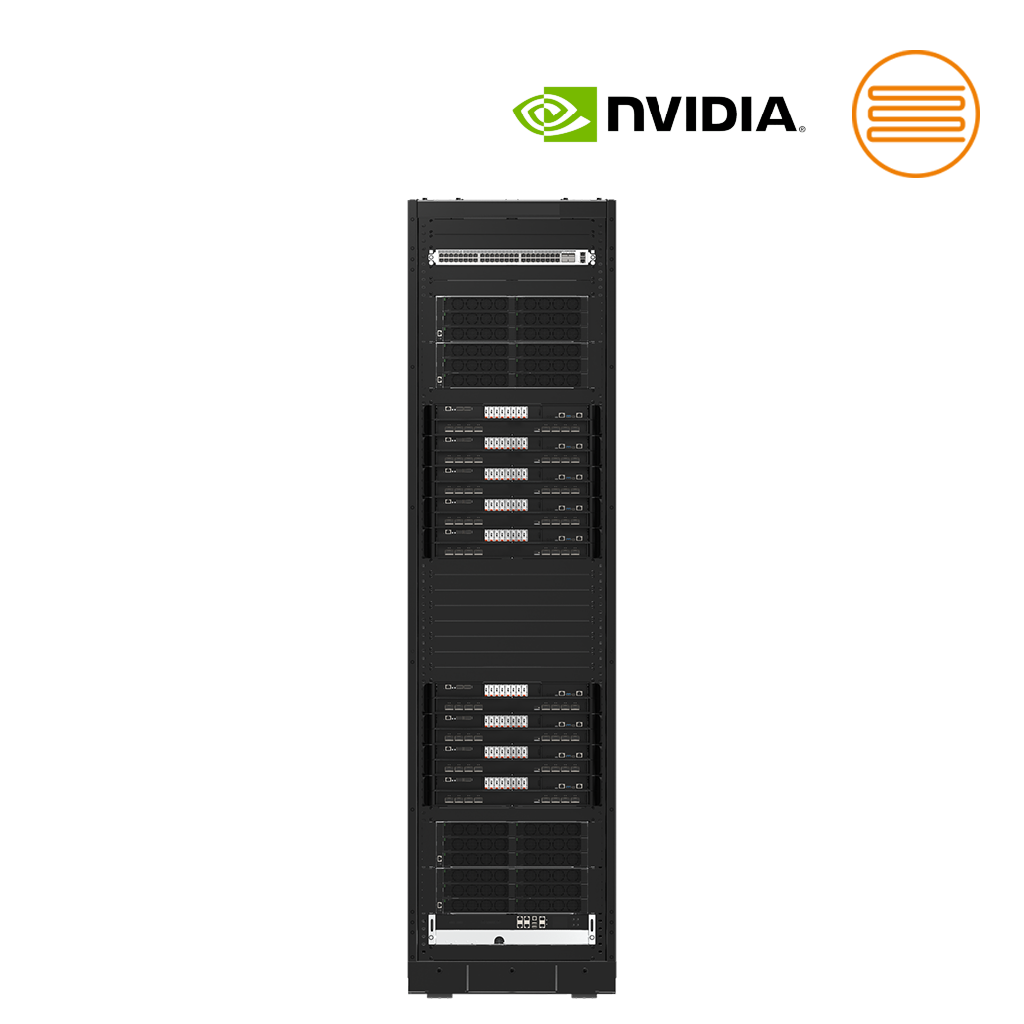
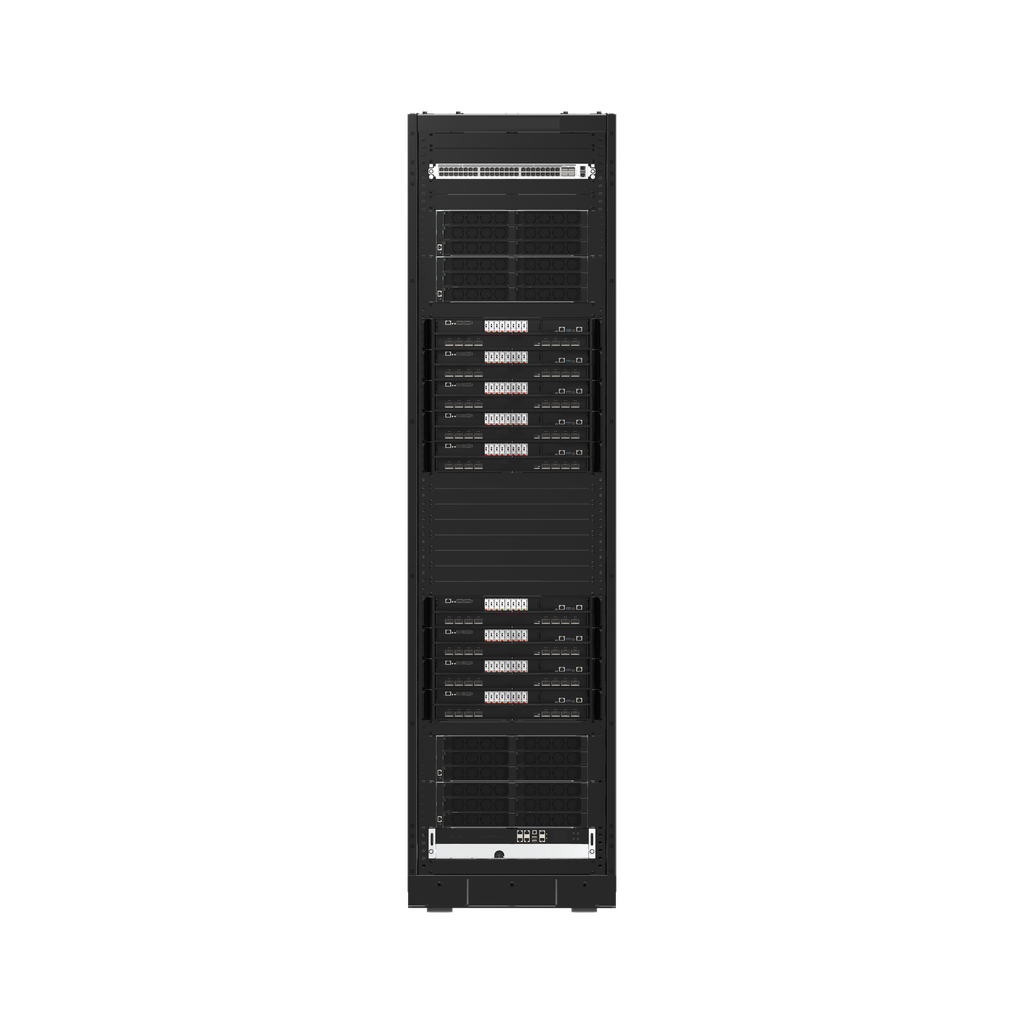
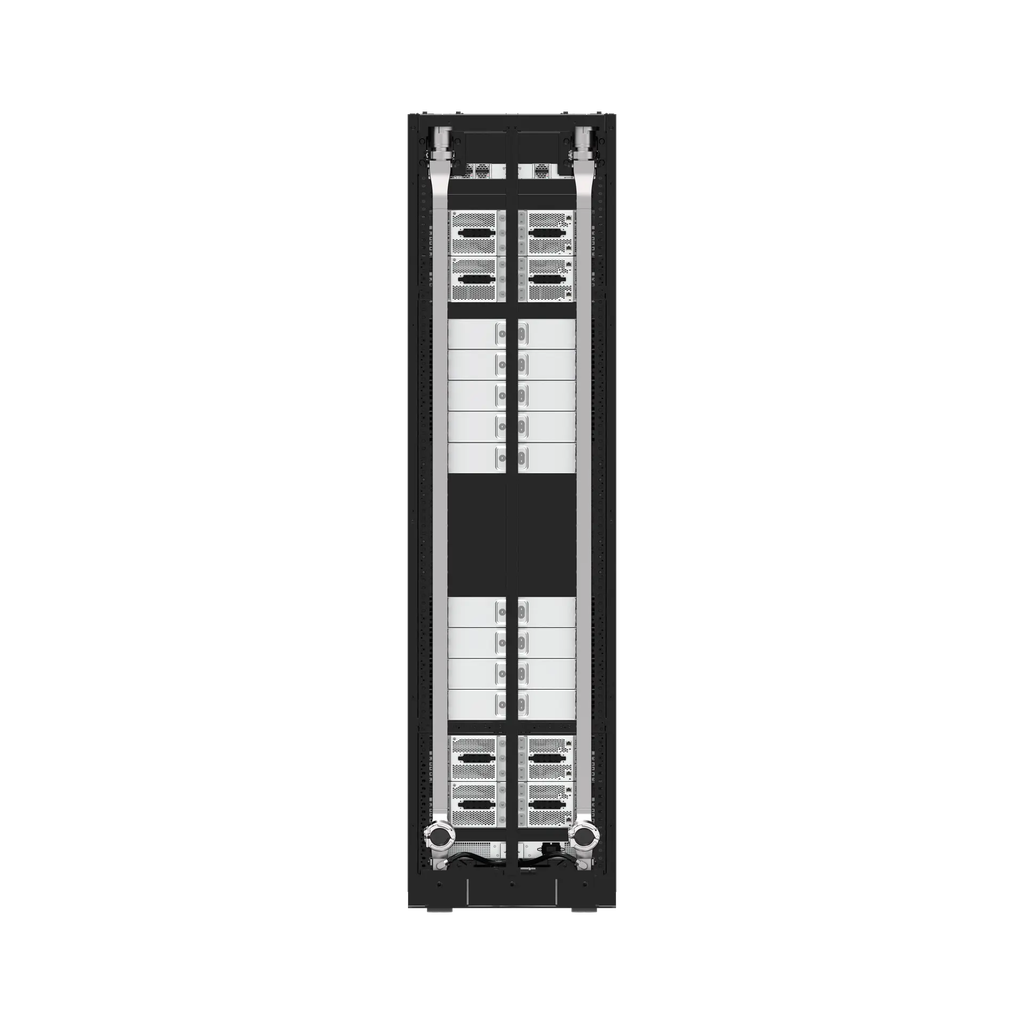
Cette solution rack repose sur la plateforme NVIDIA HGX™ Rubin NVL8. C'est une infrastructure IA clé en main, conçue pour les charges de travail les plus exigeantes. De l'entraînement de grands modèles de langage à l'inférence d'IA agentique et multimodale, elle offre des performances sans compromis, une efficacité thermique optimale et une grande simplicité d'exploitation, le tout dans un rack unique et entièrement intégré.
Évolutive dès le premier jour
Elle est pensée pour évoluer avec votre activité. Que vous déployiez un seul rack ou un supercalculateur IA multi-racks de plusieurs centaines de GPU, nous vous apportons une solution de bout en bout éprouvée, adossée à notre partenariat étroit avec NVIDIA.
Chaque composant, chaque configuration et chaque déploiement est validé selon les standards NVIDIA en matière d'infrastructure IA. Résultat : une compatibilité garantie, des performances optimisées et la fiabilité nécessaire à vos charges de travail critiques.
Performances de Rubin pour l’entraînement et l’inférence IA
Entraînement de l’IA
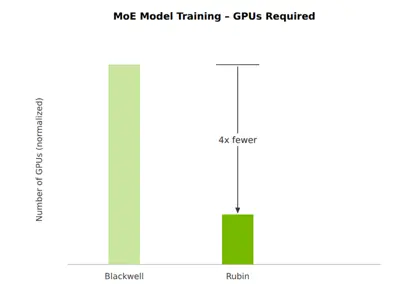
Source: NVIDIA Rubin platform announcement (CES 2026).
Grâce à NVLink 6, à 288 Go de HBM4 par GPU et à un Transformer Engine de troisième génération compatible NVFP4, Rubin peut entraîner de grands modèles MoE avec jusqu'à 4 fois moins de GPU
Inférence raisonnée en IA
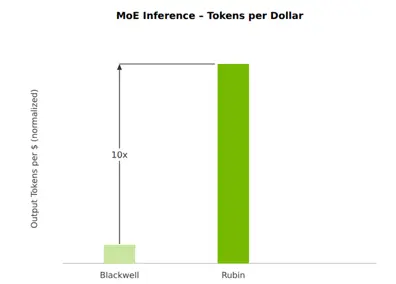
Source: NVIDIA Rubin platform announcement (CES 2026).
NVIDIA Rubin réduit jusqu'à 10 fois le coût par token par rapport à NVIDIA Blackwell sur les modèles de raisonnement de type mixture-of-experts (MoE)
Refroidissement direct par liquide
Augmentez la densité de votre data center et atteignez un PUE inférieur à 1,1 grâce à l’efficacité de nos solutions DLC.
Coolant Distribution Unit (CDU)
Les systèmes HGX Rubin sont conçus nativement pour le refroidissement liquide direct-to-chip (DLC) à des densités par rack extrêmes. À ces niveaux de puissance, le refroidissement passe du rack à la rangée. Par rapport aux unités intégrées au rack, cette approche apporte plus de capacité de refroidissement, une meilleure efficacité et une maintenance simplifiée.
La génération Rubin est conçue pour supporter des températures d'alimentation jusqu'à 45 °C. Le besoin en groupes froids est fortement réduit ce qui diminue à la fois la consommation énergétique et le coût total de possession. Les pompes et alimentations redondantes N+1 des CDU maintiennent la circulation du fluide dans toute la rangée, même en cas de défaillance d'un composant.
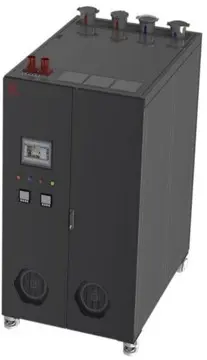
In-Row CDU
Que vous déployiez quelques nœuds HGX Rubin ou un supercalculateur IA multi-racks de plusieurs milliers de GPU, nos ingénieurs conçoivent et dimensionnent l'ensemble de l'architecture de refroidissement pour votre site. Cela comprend des CDU en rangée d'une capacité unitaire allant jusqu'à 1 350 kW, le réseau de fluide secondaire et l'intégration du rejet de chaleur avec votre infrastructure existante.